Multiverse ya tiene competencia: una startup de Caltech comprime modelos chinos 9 veces y los ofrece gratis
La compresión de grandes modelos de inteligencia artificial ya no es un terreno prácticamente exclusivo de Multiverse Computing. La startup estadounidense PrismML, surgida de investigaciones desarrolladas en la universidad californiana Caltech, acaba de presentar Bonsai 2 27B, una versión comprimida del modelo chino Qwen3.8 27B que ocupa nueve veces menos que el original y que, según las pruebas publicadas por la compañía, conserva el 98,2% de su rendimiento. Y hay una diferencia importante respecto a la estrategia de la empresa donostiarra: los pesos de Bonsai se pueden descargar gratuitamente bajo licencia Apache 2.0.
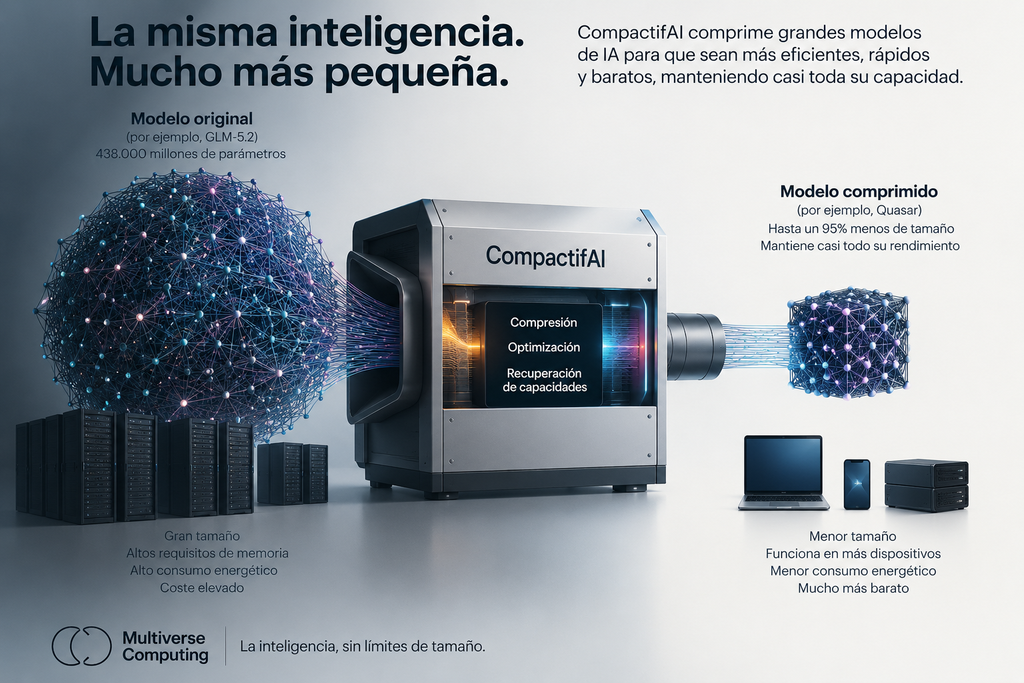
El paralelismo con Multiverse es llamativo. Las dos compañías parten de grandes modelos desarrollados por terceros y tratan de reducir drásticamente los recursos necesarios para utilizarlos. Y, en ambos casos, sus últimos productos parten precisamente de modelos chinos: Multiverse ha construido Quasar 438B sobre GLM-5.2, desarrollado por Z.ai, mientras PrismML ha utilizado Qwen3.8 27B como base para Bonsai 2.
PrismML ha conseguido reducir Qwen3.8 27B hasta apenas 5,9 GB mediante una representación ternaria en la que los pesos pueden adoptar fundamentalmente tres valores: -1, 0 y +1. El resultado equivale a 1,76 bits efectivos por peso, frente a los 16 bits que puede utilizar una versión convencional en precisión completa. La compañía asegura que el modelo resultante ocupa más de nueve veces menos y conserva el 98,2% del rendimiento agregado del original en su batería de pruebas.
La consecuencia práctica es que un modelo de 27.000 millones de parámetros puede funcionar localmente en equipos que hasta ahora no podían alojarlo. PrismML lleva precisamente meses orientando su tecnología hacia teléfonos, ordenadores portátiles y dispositivos edge. Su anterior Bonsai 27B ya ocupaba 5,9 GB en su variante ternaria y llegó a presentar una versión de 3,9 GB diseñada para poder funcionar incluso en un teléfono móvil.
Es exactamente el problema que Multiverse pretende resolver con CompactifAI: reducir la memoria, capacidad de computación, consumo energético y coste necesarios para utilizar grandes modelos. La empresa vasca asegura que su tecnología puede reducir hasta un 95% el tamaño de determinados LLM manteniendo su rendimiento y ha construido buena parte de su enorme crecimiento durante los últimos dos años alrededor de esta tecnología.
Las tecnologías empleadas son diferentes. Multiverse desarrolló CompactifAI a partir de redes tensoriales inspiradas en técnicas procedentes de la computación cuántica y posteriormente ha añadido otros procedimientos de poda, cuantización y recuperación de capacidades. PrismML apuesta especialmente por llevar los pesos a precisiones extremadamente bajas, de uno o pocos bits. Ambas persiguen, sin embargo, un objetivo comercial muy parecido: concentrar la inteligencia de un gran modelo en una infraestructura mucho menor.
La aparición de PrismML resulta especialmente relevante porque Multiverse ha construido una valoración de más de 2.000 millones de euros alrededor de la expectativa de que la compresión de IA se convierta en un enorme mercado. Su ronda de 189 millones de euros de 2025 estuvo precisamente justificada por el potencial de CompactifAI para reducir hasta un 95% los modelos y llevar la inteligencia artificial desde los grandes centros de datos hasta dispositivos mucho más pequeños.
PrismML demuestra como mínimo que Multiverse no está sola en esa carrera. La startup fue fundada por Babak Hassibi, profesor de Ingeniería Eléctrica en Caltech, y su tecnología procede de investigaciones desarrolladas en esta universidad. Entre sus asesores figura además Ion Stoica, profesor de Berkeley y cofundador de Databricks, una de las mayores compañías privadas de software del mundo.
Hay además una diferencia importante en el modelo de distribución. PrismML permite descargar Bonsai 2 27B bajo licencia Apache 2.0. Una empresa puede disponer de los pesos, instalarlos en su propia infraestructura y desarrollar aplicaciones encima sin depender necesariamente de PrismML como proveedor de la inferencia. La compañía ofrece incluso directamente desde su web la descarga de sus modelos.
Multiverse está siguiendo por ahora una estrategia más comercial y propietaria con Quasar. Su modelo estrella se ofrece a través de la API de CompactifAI, donde la empresa cobra por los tokens procesados, aunque Multiverse también comercializa despliegues de modelos comprimidos en la nube del cliente, en sus propios servidores y en dispositivos edge.
Eso introduce una curiosa paradoja en el discurso sobre la «IA soberana» que Multiverse está utilizando cada vez más. La empresa donostiarra defiende que Europa puede ganar soberanía cogiendo modelos abiertos extranjeros, comprimiéndolos y adaptándolos para que puedan ejecutarse bajo control europeo. PrismML está haciendo algo conceptualmente parecido con otro modelo chino, pero permite además que cualquiera descargue directamente el resultado.
No se puede concluir todavía que PrismML comprima mejor que Multiverse. Bonsai 2 tiene 27.000 millones de parámetros mientras Quasar parte de un modelo de 438.000 millones, una diferencia de escala enorme. Tampoco existen pruebas independientes homogéneas que permitan comparar qué porcentaje de capacidades pierde cada tecnología al comprimir el mismo modelo. Las cifras del 98,2% de conservación de rendimiento y de reducción superior a nueve veces proceden de las evaluaciones publicadas por la propia PrismML.
Quasar juega además en una categoría diferente. Multiverse asegura que su modelo obtiene 43 puntos en el Artificial Analysis Intelligence Index y lo presenta como el modelo europeo con mayor puntuación en ese índice, además de haberlo especializado en programación, agentes y razonamiento. La compañía ha vuelto a someter recientemente GLM-5.2 a todo el proceso de CompactifAI para crear Quasar 1.1, recuperando posteriormente capacidades mediante un proceso de healing.
Pero la aparición de PrismML plantea una cuestión mucho más importante para el futuro de Multiverse: hasta qué punto la compresión de modelos puede convertirse rápidamente en una tecnología relativamente abundante. Si varias empresas consiguen reducir entre cinco y diez veces modelos abiertos conservando la mayor parte de sus capacidades, saber comprimir dejará de ser por sí mismo una ventaja competitiva suficiente.
La carrera se trasladaría entonces a quién comprime mejor, quién pierde menos inteligencia, quién consigue mayor velocidad y ahorro energético y, sobre todo, quién logra convertir esas mejoras técnicas en contratos empresariales. En ese terreno Multiverse dispone de una ventaja considerable: lleva más tiempo comercializando CompactifAI, ha captado cientos de millones de euros, mantiene acuerdos con grandes compañías tecnológicas y permite ejecutar sus modelos comprimidos sobre diferentes tipos de infraestructura. Su reciente colaboración con Intel, por ejemplo, permite utilizar modelos CompactifAI directamente sobre procesadores Xeon 6.
Pero PrismML introduce además una presión adicional sobre los precios. Si un modelo comprimido suficientemente bueno puede descargarse gratuitamente, la propuesta de valor de los proveedores comerciales tendrá que residir cada vez más en conseguir resultados superiores, comprimir modelos mucho mayores, proporcionar soporte empresarial o reducir de manera demostrable los costes totales de inferencia.
La competencia puede ser también una buena noticia para Multiverse, porque confirma que el problema que intenta resolver es real. PrismML habla de «intelligence density»; Multiverse de hacer la IA más eficiente y desplegable. Las dos parten de la misma constatación: el crecimiento continuo del tamaño de los modelos está chocando con el coste de los centros de datos, la disponibilidad de chips y el consumo energético.
Lo que empieza a cambiar es la posibilidad de presentar la compresión extrema como una tecnología excepcionalmente singular. Multiverse nació en la computación cuántica y ha utilizado ese origen como elemento diferenciador de CompactifAI, pero competidores como PrismML están llegando a resultados llamativos mediante otras técnicas y sin necesidad de recurrir al componente cuántico.
Y el caso resulta todavía más interesante por una coincidencia: las dos compañías están construyendo parte de su negocio occidental sobre la extraordinaria proliferación de modelos abiertos chinos. Multiverse toma GLM-5.2 y lo convierte en Quasar; PrismML toma Qwen3.8 y lo convierte en Bonsai. Frente a la enorme inversión necesaria para crear un modelo fundacional desde cero, está emergiendo otra industria potencialmente mucho más barata: coger la inteligencia desarrollada en China, comprimirla y convertirla en un producto más barato y eficiente para el mercado occidental.
Sobre el Autor

José A. del Moral
Socio director de Alianzo, fundador de Startup 2.0 y business angel. Fue socio fundador de Ya.com. Ha coescrito dos libros sobre la Web 2.0. El Mundo lo incluye todos los años desde 2011 en la lista de los 25 españoles más influyentes en Internet.